Sol
Pieza de portafolio de machine learning aplicado — entrenar, medir, hacer ablaciones y entregar un modelo de lenguaje desde cero
- Rol
- Ingeniero de ML
- Stack
- PyTorchTinyStoriesBPE TokenizationStreamlitHugging Face HubCUDAYAML Configs
El demo de Sol está detrás de un login: la app genera texto en cada petición, y una URL abierta dejaría que cualquiera agote su presupuesto. Escríbeme y te envío las credenciales. Solicitar credenciales
Por qué lo construí
Sol no es un producto que intente resolver el problema de un usuario: es una demostración de habilidades para roles de ML aplicado y de ingeniería de ML. Los reclutadores y hiring managers que me evalúan necesitan evidencia de que entiendo la dinámica del entrenamiento, la tokenización, el diseño de evaluación y los trade-offs de hardware — no sólo cómo llamar a una API.
Hacerle fine-tuning a un modelo preentrenado es más rápido, pero es una señal más débil sobre los fundamentos. Sol es lo contrario: un transformer pequeño, entrenado como se debe y medido con honestidad, con cada cifra respaldada por pruebas y artefactos, para que puedas ver cómo trabajo en vez de qué entregué.
Qué es
Un transformer decoder-only de 52.901.712 parámetros, escrito a mano en src/model.py (~300 líneas, informado por nanoGPT pero sin ser un fork) y entrenado desde cero sobre TinyStories en una sola RTX 4070 Laptop GPU (8 GB, BF16). Sin pesos preentrenados. El repositorio es la hoja de vida: contiene el stack completo.
- Datos — descarga, embudo de deduplicación, detección de leakage entre splits, BPE byte-level in-domain de 32k, shards binarios, notebook de EDA, data card
- Entrenamiento — schedule de learning rate coseno, grad clip, checkpoint/resume con estado del RNG, compuertas de humo M4 (overfit sobre un batch, benchmark de VRAM)
- Evaluación — perplejidad sobre toda la validación con IC bootstrap de 10k, tres baselines de n-gramas, rúbrica con anclas de 1–5 sobre 60 prompts, métricas automáticas de repetición
- Deploy —
SolGeneratorensrc/infer.py, Streamlit en Community Cloud, pesos en Hugging Face Hub
Pruébalo en vivo — dale el comienzo de un cuento infantil y lo termina. Código en GitHub — clónalo, corre las pruebas, lee la data card.
Habilidades que demuestra
| Área | Evidencia en el repositorio |
|---|---|
| Ingeniería de ML | Transformer escrito a mano, loop de entrenamiento, schedule de learning rate, checkpoint/resume, compuertas de humo M4 |
| Ciencia de datos | Embudo de deduplicación, corrección del leakage entre splits, EDA, data card, IC bootstrap, ablaciones con la varianza entre semillas como vara de medir |
| Diseño de evaluación | Perplejidad frente a 3 baselines, rúbrica con anclas (60 prompts), métricas automáticas de repetición |
| Sistemas / MLOps | Configuraciones YAML, prueba de drift de la especificación en CI, 154 pruebas, pipeline de exportación, deploy por debajo de 1 GB de RAM |
| Comunicación honesta | Documento de limitaciones por milestone, resultado nulo de una ablación publicado, objetivo de preentrenamiento equivocado reconocido |
Arquitectura y entrenamiento
| Componente | Elección | Por qué |
|---|---|---|
| Capas × heads | 8 × 8 (head_dim 74) | Cabe en 8 GB con margen — pico de 2.344 MiB medido |
| Dimensión del embedding | 592 (no 512) | 512 medía apenas 41,8M de parámetros; 592 queda dentro del 1,73% del objetivo de ~52M |
| Contexto | 512 tokens | El 99,74% de los documentos de entrenamiento cabe entero — medido en el EDA |
| Vocabulario | 32k BPE | Entrenado sólo sobre el split de entrenamiento, byte-level |
| Precisión | BF16 | Nativo en Ada Lovelace; no hace falta GradScaler |
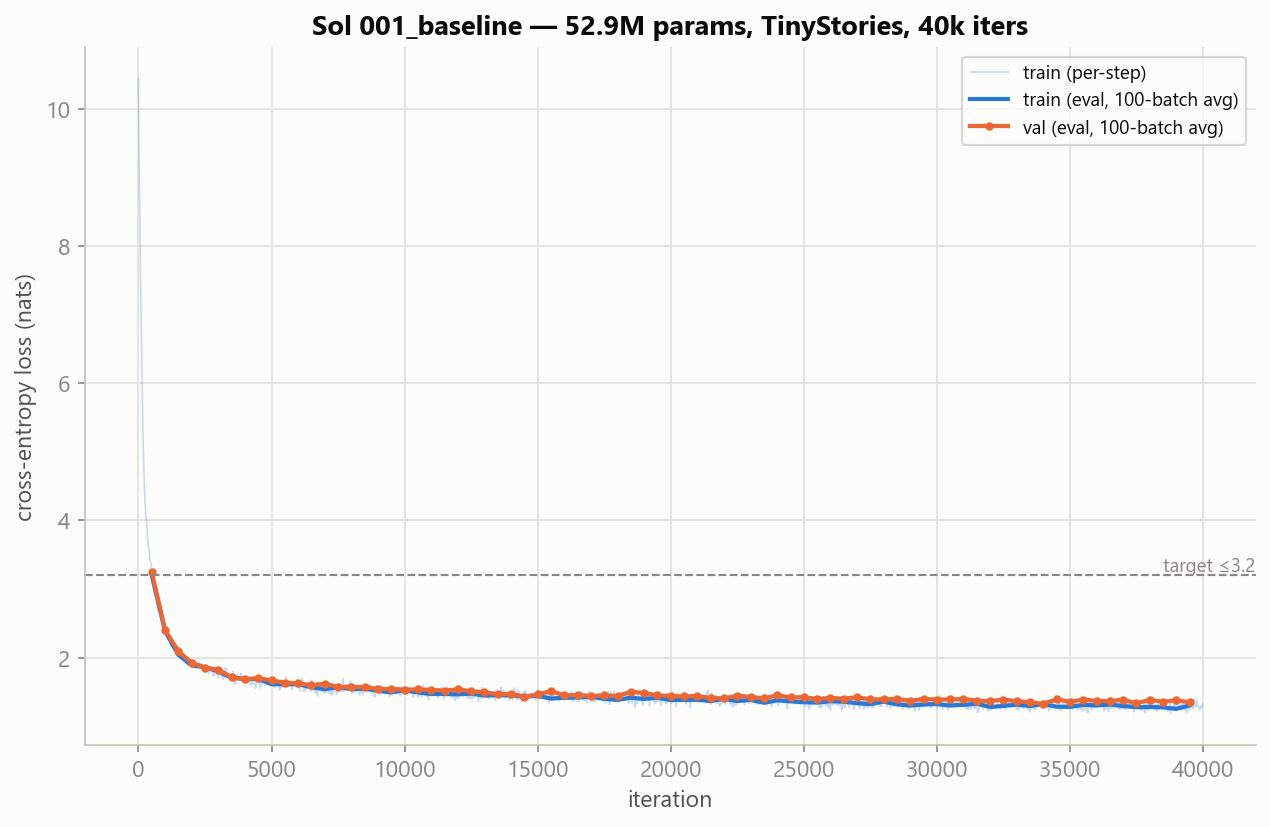
| Throughput | ~20.067 tok/s | 40k iteraciones → 1,31B tokens en ~16,9 h de entrenamiento despierto |
La atención usa scaled_dot_product_attention con máscara causal (probado: perturbar tokens futuros no puede cambiar los logits en la posición t). Después del entrenamiento se agregó un KV cache con prueba de identidad byte a byte en fp32 — 3,5× en CPU localmente, 1,8× en el host desplegado de Streamlit.
Resultados
Perplejidad de validación
3,719
IC 95% [3,693; 3,745], 15.141 documentos, 10.000 remuestreos bootstrap
Pico de VRAM
2.344 MiB
El objetivo era < 7.400 MiB en una RTX 4070 Laptop GPU de 8 GB, BF16, sin gradient checkpointing
Frente a los baselines (mismo conjunto de validación, mismo tokenizer)
El objetivo original era de 15–25 ppl — una conjetura previa a cualquier medición. La comparación que interesa es contra los baselines sobre datos idénticos, no contra esa conjetura.
Rúbrica con anclas
n = 60 prompts
La gramática puntúa 4,00/5, pero la coherencia apenas 3,15/5 — oraciones limpias, pero deriva de entidades pasados ~150 tokens. La perplejidad por sí sola no sacaría a la luz esa brecha.
Evaluado documento por documento sobre todo el conjunto de validación, con intervalos de confianza bootstrap, frente a tres baselines — porque «perplejidad 3,7» no significa nada si no se sabe qué puntúa un modelo de trigramas sobre los mismos datos.
El objetivo de preentrenamiento de 15–25 ppl estaba equivocado; no es que el modelo haya sido excepcional. El resultado interesante es la división de la rúbrica: gramática fuerte, coherencia débil. El modelo escribe oraciones limpias y pierde la pista de quién está en el cuento.
Por qué esto no es fine-tuning
| Sol | Proyecto típico de fine-tuning |
|---|---|
| Arquitectura escrita a mano con pruebas de causalidad | Cargar pesos preentrenados |
| Tokenizer in-domain entrenado sólo sobre el split de entrenamiento | Reusar un tokenizer existente |
| Embudo de deduplicación + detección de leakage + data card | Descargar el dataset, limpieza mínima |
| Perplejidad + IC bootstrap frente a 3 baselines | «la loss bajó» |
| Varianza entre semillas como vara de medir para las ablaciones | Ablaciones de una sola corrida |
Guarda de drift de la especificación (export_spec.py + prueba en CI) | Las cifras del README se desfasan |
| Deploy bajo una restricción de 1 GB de RAM | gradio launch |
Enfoque de ciencia de datos
- Pipeline: 2.119.719 documentos crudos → 1.748.358 documentos de entrenamiento conservados / 357,9M tokens; embudo de deduplicación documentado que rastrea cada cifra hasta su artefacto.
- Hallazgo de leakage: el 28,67% de los documentos crudos de validación eran duplicados exactos de documentos de entrenamiento — no redundancia interna de la validación. Se descartaron 6.304 antes de cualquier métrica reportada.
- Experimentación: barrido de learning rate y ablación de escala de datos, ambos leídos contra la varianza entre semillas medida (±0,0045 ppl) en vez de a ojo.
- Nulo honesto: la escala de datos (100M frente a los 357,9M tokens completos) movió la perplejidad apenas ~18× el piso de ruido entre semillas — la tasa de duplicados exactos del 14,58% dentro del split de entrenamiento de TinyStories puede explicar por qué una porción más pequeña sigue pareciéndose al corpus completo.
Ablaciones
Tres semillas con configuración idéntica: 4,490 ± 0,0045 de perplejidad — la vara de medir para todo lo demás.
- Learning rate (1e-4 / 3e-4 / 1e-3 → 5,380 / 4,489 / 4,162) — brechas de ~271× el piso de ruido entre semillas. Efecto grande y real.
- Escala de datos (100M frente al corpus completo → 4,572 frente a 4,489) — apenas ~18× el piso. La variable que suena como si debiera importar más fue la que menos importó.
Deploy
Hugging Face dejó los Gradio Spaces detrás de PRO a mitad del proyecto (402 Payment Required). La app de Gradio ya funcionaba; portarla a Streamlit Community Cloud tomó cerca de una hora con cero cambios en el código de inferencia, porque SolGenerator vive en un solo módulo.
Ingeniería para el tier gratuito: fijar Python 3.12 y torch sólo de CPU, @st.cache_resource bajo un techo de 1 GB de RAM, un bundle de pesos de 103,1 MiB y un KV cache que lleva la generación desplegada de 16 → 29 tok/s.
Limitaciones
La coherencia es la restricción que manda — las entidades nombradas derivan a lo largo de unos 150 tokens. Sólo cuentos infantiles; sin instruction tuning; continuará una pregunta como prosa en vez de responderla (en tema 5,00/5 in-domain frente a 1,47/5 out-of-domain). El mojibake en un pequeño porcentaje de las generaciones se rastrea hasta el 6,20% de los documentos originales de TinyStories — heredado, documentado, no parchado en silencio.
Todo queda registrado en el documento vivo de limitaciones del repositorio, escrito por milestone en vez de armado al final.
Puntos clave
- Transformer decoder-only escrito a mano (~52,9M de parámetros) — arquitectura, data pipeline, entrenamiento, evaluación, ablaciones y deploy; sin pesos preentrenados
- Perplejidad de validación 3,719 (IC 95% [3,693; 3,745]) frente a 23,4 del trigrama, sobre el mismo conjunto de validación de 15.141 documentos
- Se detectó leakage entre splits: 6.304 documentos de validación eran duplicados exactos de documentos de entrenamiento — se descartaron antes de evaluar
- Gramática 4,00/5 pero coherencia 3,15/5 en una rúbrica con anclas — la perplejidad por sí sola no vería el límite real
- 154 pruebas + especificación generada con guarda de drift en CI; demo en vivo en el tier gratuito de Streamlit (103 MiB de pesos en Hugging Face)
Retos
Resultados
- Demuestra responsabilidad de punta a punta en ML: data → train → eval → ablation → deploy — no integración de APIs
- Roadmap M0–M9 completo en una sola GPU de portátil de 8 GB (BF16, 1,31B tokens, 40k iteraciones)
- Un artefacto público que un reclutador puede inspeccionar: repositorio en GitHub, pesos en Hugging Face y demo en vivo en Streamlit
- Cifras listas para una entrevista, con guarda de drift en CI — cada métrica se rastrea hasta una prueba o un artefacto
Demo
Abrir app en vivoPerplejidad de validación
3,719
IC 95% [3,693; 3,745] sobre 15.141 documentos
frente al baseline de trigrama
23,4
Unigrama 379, uniforme 32.000
Rúbrica: gramática
4,00 / 5
Puntuada a mano sobre 60 prompts
Rúbrica: coherencia
3,15 / 5
La limitación que manda — deriva de entidades pasados ~150 tokens, no gramática
La especificación original apuntaba a una perplejidad de 15–25. Se midió 3,719 — lo que significa que el objetivo estaba equivocado sobre qué tan difícil es TinyStories, no que el modelo haya rendido por encima de lo esperado. La inferencia desplegada corre a 29 tokens/segundo en una vCPU compartida gratuita.