Lante
Company Brain para operaciones de logística — de exportaciones de WhatsApp a una traza de auditoría GraphRAG con citas
- Rol
- Desarrollador único
- Stack
- PythonFastAPINext.jsPWATypeScriptPostgresQdrantFalkorDBDocker
Lante no tiene una URL pública disponible todo el tiempo: el stack se levanta a solicitud. Escríbeme, apruebo el acceso, coordinamos una hora y enciendo el proyecto para un recorrido en vivo. Solicitar un recorrido
El problema
En muchos entornos de trabajo, llevar varios proyectos en paralelo sin perder el hilo es difícil — y se pone más difícil a medida que cada proyecto suma piezas móviles, stakeholders y excepciones.
La mayoría de la gente no vive en una herramienta de gestión de proyectos. Vive en el correo y en WhatsApp, sobre todo en América Latina. Las actualizaciones, los traspasos y los momentos de «¿en qué quedamos con esto?» se dispersan entre hilos en vez de quedar en un solo lugar confiable.
Lante ingiere lo que la gente ya envía y recibe por esos canales, y mantiene una vista del estado actual por proyecto — no sólo búsqueda, sino «¿cuál es el estado de este envío / pedido / cliente en este momento?»
El primer dominio se enfocó a propósito en la logística de carga: varios pedidos en curso, workflows cargados de protocolo y cambios repentinos (demoras, redireccionamientos, retenciones en aduana) son el trabajo normal de todos los días. Ese sector pone a prueba si el sistema puede mantenerse exacto cuando el volumen y la volatilidad son altos a la vez.
La solución
Subes una exportación de WhatsApp (o un PDF). Una vez ingerida — y confirmada en Bandeja si el ruteo era ambiguo — puedes preguntar, en español, ¿Quién prometió la entrega del pedido #8890? y recibir citas que apuntan a mensajes específicos, más una línea de tiempo con la promesa del viernes, el incumplimiento y la nueva promesa para el lunes. El chat #8890 del seed data es uno de los ambiguos: abarca varios temas, así que sí pasa por revisión.
La PWA web es el cliente que se entrega. Un paquete compartido de TypeScript (apps/shared) es el cliente de la API para web (y para la app de Expo, que sólo pasa el typecheck). FastAPI sirve la API. Docker Compose levanta Postgres, Redis, Qdrant, FalkorDB, MinIO, la API, un worker de ingesta que hace polling sobre Postgres y un worker de reglas.
El recorrido y el acceso al repositorio privado están disponibles a solicitud — no hay una URL pública disponible todo el tiempo. Ver Cómo verlo.
Stack técnico
| Capa | Qué se entrega realmente |
|---|---|
| Lenguaje / API | Python 3.11, FastAPI, Pydantic, SQLAlchemy, Alembic (12 revisiones) |
| Web | Next.js 15, React 18, TypeScript; PWA vía manifest.json, sw.js, prompt de instalación |
| Cliente compartido | apps/shared — wrappers tipados de fetch que usa la PWA |
| Almacenes de datos | Postgres 16 (sistema de registro), Redis 7 (rate limits y tokens de vida corta — no la cola de ingesta), Qdrant (vectores de los chunks), FalkorDB (grafo de entidades sobre el protocolo de Redis), MinIO (archivos crudos subidos) |
| LLM | Por defecto gpt-4o-mini con temperature 0 en extracción; embeddings text-embedding-3-small (1536-d); opcionalmente Qwen por workspace vía DashScope |
| Evaluación / extras de NLP | Conjuntos gold JSONL anotados a mano, rapidfuzz, pdfplumber para PDFs |
| Móvil / extras | La app de Expo 52 pasa el typecheck en CI; el módulo del bot de Telegram existe; telegram: false en todos los planes de packages/billing/tiers.py |
Redis está en el stack. El worker no consume una cola de Redis: hace polling sobre la tabla Job de Postgres.
Habilidades que demuestra
| Habilidad | Evidencia en el repositorio |
|---|---|
| NLP aplicado / extracción | Prompt en español para el LLM + esquema JSON, fallback heurístico _mock_extract, capa de regex de compromisos, resolver de rapidfuzz (umbral 85) |
| Recuperación de información | Retriever híbrido: búsqueda vectorial en Qdrant + Cypher en FalkorDB para las aristas de compromiso, fusión léxica de +0,1, citas con sender y timestamp |
| Diseño de evaluación | Split gold/test de extracción de 93 filas, 48 negativos, 20 fenómenos (≥3 cada uno), prueba de higiene contra fixtures circulares, conjunto gold de retrieval de 21 preguntas con puntuación de remitente/fecha en las citas |
| Ingeniería de producto con LLM | Copiloto de operaciones con herramientas, síntesis determinista para preguntas sobre promesas de entrega, blocklist bilingüe de entrada, negativas en español, guardas opcionales de tema/contenido con NVIDIA NeMo (apagadas por defecto) |
| Backend multi-tenant | require_workspace_access / WorkspaceDep; test_route_auth_coverage.py enumera las rutas vivas; verificación del payload por workspace en cada resultado vectorial |
| Producto full-stack | Inbox con HITL, líneas de tiempo, UI del copiloto con tarjetas de citas, exportación de auditoría a CSV/PDF, PWA |
| Criterio de producción | Los rate limits fallan abiertos; un desajuste en la dimensión del embedding lanza excepción; el modo demo se niega a arrancar sin registro cerrado + correo de sólo lectura; CI vacía las llaves del LLM en el carril de unitarias |
Esto no demuestra inferencia estadística, pronósticos ni entrenar un modelo desde cero (eso es Sol).
Arquitectura
Dos índices a propósito. La búsqueda vectorial responde «qué se dijo sobre la carga». El recorrido del grafo responde «quién prometió qué». El retrieval consulta ambos.
| Capa | Elección | Por qué (y dónde) |
|---|---|---|
| Chunking | 800 caracteres, 100 de solapamiento | packages/ingestion/chunker.py |
| Extracción | gpt-4o-mini, temperature 0, extract_entities_es.md | Español colombiano informal; ruta heurística si el LLM devuelve vacío |
| Embeddings | text-embedding-3-small (1536-d); mock de 384-d sin llave | packages/indexing/embedder.py — la dimensión de la colección queda fija al crearla |
| Almacén vectorial | Qdrant | Una sola colección compartida. document_id usa un filtro del lado del servidor; workspace_id se verifica en cada payload devuelto (ver abajo) |
| Grafo | FalkorDB | Cypher; menor huella operativa que Neo4j |
| Resolución de entidades | token_sort_ratio de rapidfuzz, umbral 85 | «Fernando» / «Fernando Quintero» / «don Fernando» |
| Serving | FastAPI + worker que hace polling sobre Postgres | Sin message broker; la ingesta es de escala de minutos |
Dónde ocurre realmente el aislamiento entre tenants en la búsqueda vectorial. Todos los workspaces comparten una sola colección de Qdrant. document_id se empuja hacia abajo como un Filter del lado del servidor, pero workspace_id se impone en el código de la aplicación: vector_writer.search() descarta cualquier punto devuelto cuyo workspace_id del payload no coincida. El aislamiento se sostiene, pero de ahí se siguen dos cosas que hay que decir con honestidad: los vecinos más cercanos de otro tenant pueden consumir parte del presupuesto de top_k antes de ser descartados, y la garantía vive en una sola línea de Python en vez de en la base de datos. Un índice sobre el payload con una cláusula must del lado del servidor es el arreglo correcto, y no está hecho.
El human-in-the-loop es condicional, no universal. should_queue_for_review() manda un documento a Bandeja cuando se parte en varios segmentos, cuando se detecta más de un tema, cuando una sugerencia de ruteo puntúa por debajo de 0,7 de confianza, o cuando el workspace activa require_timeline_approval (por defecto false). Una subida de un solo tema y con confianza alta va directo a una línea de tiempo. Lo que se afirma es que los casos ambiguos entran a la cola — no que un humano apruebe todo.
Medición
Vale la pena citar dos harnesses. Un tercer archivo, agent_eval.jsonl, tiene tres casos y todavía menciona el Carlos / #4521 del fixture viejo: no es una métrica publicada.
Extracción (offline)
93 filas anotadas a mano (62 gold / 31 test) sobre 7 exportaciones de WhatsApp co_logistics_*.txt. Veinte fenómenos, cada uno etiquetado al menos tres veces. 48 filas tienen entities y relations vacíos (negativos deliberados). Toda fila lleva "synthetic": true.
Entidades requeridas: 43 en gold, 63 entre ambos splits. Relaciones: 8 en total (4 por split).
Reproducido en esta sesión, sin llave de API:
python scripts/run_extraction_eval.py --split gold --predictor heuristic
| Predictor | F1 de entidades (micro) | F1 de relaciones (micro) |
|---|---|---|
| Regex heurístico + mock extract (gold, 62 filas) | 0,692 (P 0,771 / R 0,628; 27 TP, 8 FP, 16 FN) | 0,143 (1 TP, 9 FP, 3 FN) |
gpt-4o-mini, temperature 0 (gold, registrado en datasets/README.md) | 0,933 (0,923–0,944 en 3 corridas) | 0,800 (igual en esas 3 corridas de gold) |
Las 9 relaciones falsas frente a 1 verdadera son la razón de que exista la ruta con LLM. En esa misma corrida heurística, el F1 de entidades de colombian_logistics_term es 0,286 y el de negative_ack es 1,000; la confusión de tipos es Location→Person 3, Organization→Person 2.
Las cifras de entidades/relaciones del LLM de arriba no se volvieron a correr en esta pasada (necesitan OPENAI_API_KEY). Son las cifras registradas junto con el corpus en packages/evaluation/datasets/README.md.
Retrieval (con el stack levantado)
retrieval_gold_set.jsonl — 21 preguntas que cubren las siete conversaciones. Puntuación: fracción de los substrings de expected_contains presentes en la respuesta, y si alguna cita coincide con expected_citation_sender y con el mismo día calendario de expected_citation_timestamp. La compuerta en scripts/run_eval.py: retrieval ≥ 0,80, citas ≥ 0,70. Necesita Docker + un workspace con seed data + una llave de API. Aquí no se cita ninguna cifra de esa compuerta.
Honestidad sobre las cifras
El F1 de relaciones no tiene potencia estadística. Ocho relaciones en total. En el split de test, dos corridas del LLM con el mismo prompt puntuaron 0,571 y 1,000. No trates el 0,800 de gold como una cifra estable de capacidad.
Un solo anotador, corpus sintético. No hay acuerdo entre anotadores. Trata el F1 como una cota superior. Exportaciones reales anonimizadas pondrían "synthetic": false en el mismo esquema.
El conjunto gold de retrieval viejo era circular. packages/evaluation/gold_set.jsonl sigue existiendo para reproducir las cifras antiguas; no es la compuerta por defecto.
Modos de falla
Observados sobre este corpus / este código:
- Matizaciones. «si acaso llega el viernes, todavia no es seguro por el clima» está etiquetado como
hedged_noncommitment(3 filas).commitment_extractor.pyigual dispara con el regex cercano aentrega. Inventar una promesa es peor que perderse una. - Las promesas superadas se agregan, no se reemplazan.
#8890el viernes y después el lunes: ambas aristas pueden existir.valid_fromse fija en las relaciones (temporal_edges.py); nada marca la primera como anulada. - Tildes. Los nombres en gold son textuales (
trancón,Julián). El emparejamiento normaliza las tildes durante la evaluación; «arreglar» las cadenas del gold seguiría estando mal. - Confusión de tipos en la heurística. Los tokens en español con mayúscula inicial caen por defecto en Person dentro de
_mock_extract— de ahí Location→Person / Organization→Person en el baseline. - Sujetos implícitos. «hay un trancon verraco en la via al Llano» está anotado con una ubicación y ninguna relación, porque el extractor ve
msg.body, nosender: body. - La respuesta determinista está afinada a este corpus.
answer_synthesis.pydispara con cualquier pregunta sobre promesas de entrega que nombre una orden de tres o más dígitos, pero la frase de dos fechas («primero el viernes, luego reprogramado al lunes») está anclada a las palabras literalesviernesylunes. Es una respuesta correcta y barata para los chats con seed data, y necesitaría parseo real de fechas para generalizar.
Consideraciones de producción
| Consideración | Implementación |
|---|---|
| Aislamiento multi-tenant | Las rutas con workspace_id en la ruta o en el body deben llamar al helper de membresía. tests/unit/test_route_auth_coverage.py recorre la app viva. El comportamiento de denegación está en test_tenant_isolation.py (requires_infra, no entre las 431 offline) |
| Rate limiting | Ventana fija en Redis: login 5/min/IP, registro 3/hora/IP, LLM/copiloto 30/min por identidad (/v1/consulting/chat incluido). Falla abierto si Redis está caído |
| Prompt injection | Dos capas en la ruta del copiloto: un tope de 500 caracteres más una blocklist bilingüe (security_blocklist.py — override de instrucciones en español e inglés, extracción del system prompt, bloques de código, peticiones de inyección SQL), y luego una verificación opcional de tema con NeMo NIM (nemo_guardrails_enabled por defecto false) y una pasada de seguridad sobre la salida. Una verificación aparte, de cuatro frases y en inglés, vive en guardrails.py. Las negativas son en español |
| Costo | OpenAI o Qwen por workspace. Copiloto 30/min. Las preguntas sobre promesas de entrega pueden saltarse el LLM vía answer_synthesis.py |
| Migraciones | Alembic, 12 revisiones; el contenedor migrate debe salir con 0 antes de que arranque api |
| Dimensión del embedding | Mock de 384-d frente a 1536-d de OpenAI; embedding_dimension() debe coincidir con la colección de Qdrant |
| Seguridad del modo demo | ENVIRONMENT=demo no arranca a menos que el registro esté cerrado y DEMO_READONLY_EMAIL esté definido. Ese usuario no puede mutar nada; el copiloto y /v1/audit/export están en la allowlist |
431 pruebas en verde en pytest tests/unit con las llaves del LLM vacías (job test de CI). Hay una prueba más recolectada que se salta; 37 pruebas requires_infra son un job aparte.
Alcance honesto
Lo que no está en este proyecto: entrenamiento de modelos, inferencia estadística, pronósticos, un checkout de Creem en vivo, un stack de observabilidad, un build para tiendas móviles, ni un relay entrante de correo/WhatsApp en vivo (los secretos de webhook existen para poder rechazar peticiones sin firmar).
Cómo verlo
- Esta página — usa Solicitar un recorrido más abajo para agendar una sesión en vivo. Capturas y grabación después de registrarlas localmente (
docs/SCREENSHOTS.mden el repositorio). - A solicitud — workspace con seed data, guión del demo: login → feed → inbox → copiloto sobre
#8890→ línea de tiempo + exportación. Solicitar un recorrido. - Repositorio privado — a solicitud. Reproducir offline:
pip install -e ".[dev]"
python scripts/run_extraction_eval.py --split gold --predictor heuristic
python -m pytest tests/unit -q
Stack completo: docker compose --profile app up -d --build, y luego scripts/seed_public_demo.py.
Puntos clave
- Ingesta de .txt de WhatsApp y de PDF hacia un grafo de conocimiento acotado al tenant, con una cola de revisión Bandeja para los casos ambiguos (ruteo multi-tema o de baja confianza)
- Retrieval híbrido: vectores de Qdrant + aristas de compromiso en FalkorDB, fusionados con un refuerzo de score léxico, con citas de remitente y marca de tiempo
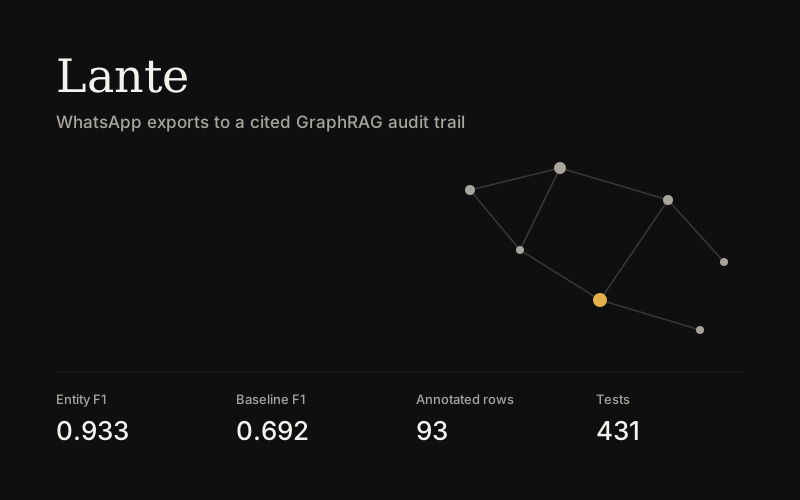
- F1 de entidades 0,933 (0,923–0,944 en 3 corridas del LLM) frente a un baseline heurístico de 0,692, sobre un corpus de 93 filas anotado a mano — 48 filas son negativos deliberados
- Toda ruta acotada a un workspace verifica la membresía; una prueba unitaria recorre la tabla de rutas viva de FastAPI (431 pruebas offline en verde)
- Línea de tiempo de auditoría de compromisos y exportación a CSV/PDF — quién prometió qué, cuándo y cuándo cambió
Retos
Resultados
- Ingest → chunk → extract → resolve → Qdrant + FalkorDB, con un workspace de logística colombiana con seed data y líneas de tiempo del tier de auditoría
- Copiloto de operaciones (en español) con tarjetas de citas; las preguntas sobre promesas de entrega que nombran un número de orden pueden saltarse el LLM mediante síntesis determinista; se niega a responder cuando falta evidencia
- Evaluación de extracción offline (`python scripts/run_extraction_eval.py --split gold --predictor heuristic`); 431 pruebas unitarias en verde, con las llaves del LLM vacías en CI
- La PWA web es el cliente que se entrega (service worker + prompt de instalación); Expo pasa el typecheck en CI pero no tiene build para tiendas; el código del bot de Telegram existe y está apagado en todos los tiers de billing
Recorrido en vivo
Lante no tiene una URL pública disponible todo el tiempo: el stack se levanta a solicitud. Escríbeme, apruebo el acceso, coordinamos una hora y enciendo el proyecto para un recorrido en vivo.
Solicitar un recorrido