Elephant in the Room
Risk-indicator screening for Colombian public procurement, with a false-positive adjudication layer that decides what gets reported
- Role
- Data engineer and analyst
- Stack
- PythonDuckDBPolarsscikit-learnPydanticTyperSECOP II / SocrataNext.js
This case study is written in Spanish, the language of the project and its data.
El problema
Colombia publica muchísimos datos de contratación. SECOP II expone 5,93 millones de contratos y 8,98 millones de procesos. Los organismos de control se ahogan en ellos.
Las herramientas de «banderas rojas» no ayudan, porque disparan todo el tiempo. En salud, el 98,6% de la contratación es no competitiva por diseño: así está previsto en la ley. Marcar la falta de competencia equivale a marcar el sector entero.
Lo difícil no es encontrar anomalías. Es defenderlas.
La solución
El núcleo del sistema no son los detectores, sino lo que viene después: una capa de adjudicación de falsos positivos. Toda señal atraviesa cinco compuertas antes de convertirse en un caso reportable.
- Calidad de datos — ¿el registro es confiable, o la anomalía es un error de captura?
- Tasa base — ¿el patrón es simplemente lo habitual en este sector?
- Cobertura legal — ¿la modalidad está amparada para esta entidad?
- Comparabilidad — ¿hay un grupo de comparables que sostenga la afirmación?
- Corroboración — ¿coinciden detectores independientes sobre el mismo sujeto?
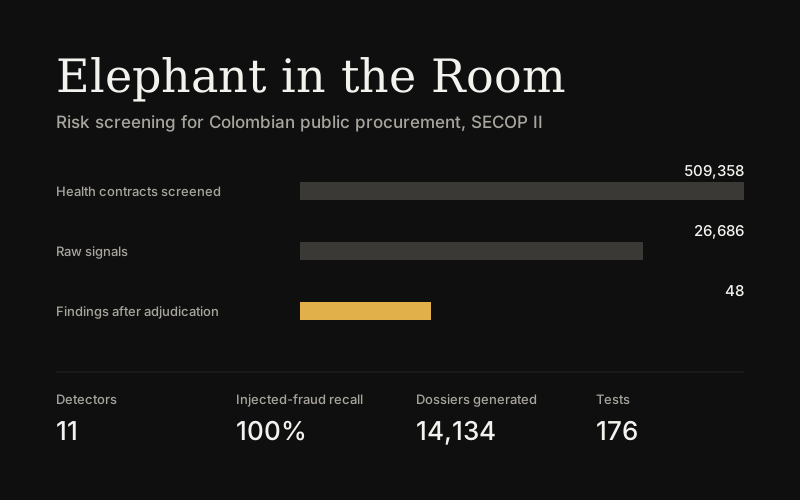
Sobre 509.358 contratos de salud entre 2022 y 2025, los once detectores produjeron 26.686 señales crudas. Después de la adjudicación quedaron 48 hallazgos y 14.086 observaciones.
Cada caso se publica con las hipótesis benignas que se evaluaron: cuáles se descartaron y, sobre todo, cuáles siguen abiertas. Una hipótesis abierta impide que el caso llegue a hallazgo. Se reporta como observación, diciendo qué fue lo que no se pudo verificar.
El modelo mide, la regla decide
Ningún modelo decide aquí qué es sospechoso. Si lo hiciera, ningún hallazgo sería falsable y se caería la premisa entera: un auditor puede discutir una regla explícita, y un abogado puede desmontar una caja negra.
Eso no significa renunciar al aprendizaje automático, sino ponerlo donde responde una pregunta verificable. D11 usa un clasificador entrenado con las 492.025 clasificaciones UNSPSC que las propias entidades declararon. Lo que afirma es acotado: este texto se parece al de los contratos que el resto del país clasifica en otra familia. Es una afirmación sobre el lenguaje, contrastable contra medio millón de ejemplos.
Lo que decide si eso se reporta es una regla con umbrales publicados —probabilidad de la familia inferida ≥ 0,95 y de la declarada ≤ 0,01— y con su piso de ruido medido sobre datos retenidos: 0,3%.
El modelo es lineal a propósito. Un transformer clasificaría mejor, pero los coeficientes de un modelo lineal se leen como palabras: el dossier puede imprimir los términos que empujaron la inferencia, y el lector puede estar en desacuerdo con ella. Un hallazgo apoyado en un embedding que nadie puede inspeccionar es justo el tipo de afirmación que este proyecto existe para evitar.
Qué significa en horas de trabajo
El sistema no reemplaza el criterio de un auditor. Reemplaza el tamizaje: mirar medio millón de contratos para decidir cuáles vale la pena mirar.
| Contratos tamizados | 509.358 (COP 59,8 billones) |
| Señales crudas | 26.686 — 1 por cada 19 contratos |
| Casos reportables | 14.134 — 1 por cada 36 contratos |
| Hallazgos | 48 — 1 por cada 10.612 contratos |
| Ejecución completa | menos de 30 minutos en un portátil, sin servidor |
A 20 minutos de revisión por contrato —un supuesto explícito, que el lector puede cambiar— revisar el sector completo son 96,5 años-persona. Revisar los 48 hallazgos son dos días-persona. Un equipo que jamás podría leer 509.358 contratos sí puede leer 48.
Hay un detalle que vale la pena señalar: esos mismos dos días producirían la cifra que al proyecto le falta. Nadie ha revisado los hallazgos uno por uno, así que la precisión real es desconocida. La primera tarea que el sistema habilita es exactamente la que cerraría su principal vacío.
Cada dossier dice cómo dejar de necesitarlo
Un indicador que sólo puede resolver un experto no escala. Siempre habrá más contratos que auditores. Por eso cada dossier cierra explicando qué dato tendría que capturarse durante el proceso de contratación para que un caso así se resolviera solo.
El primer borrador de esa sección estaba mal planteado. Parecía una lista de campos que Colombia debería inventar. Al contrastarla con lo que ya existe resultó que el estándar OCDS —al que Colombia publica desde hace años a través de la ANCP— ya define casi todos: la hora de cierre, las cantidades por ítem, las adendas con su motivo, la justificación de la modalidad, el vínculo con la planeación. Otros existen como extensiones ya escritas.
El diagnóstico correcto es más estrecho y más útil: el estándar no es el problema. La brecha está entre la publicación OCDS y las tablas planas de datos.gov.co, que son las que consume la mayoría de analistas, este proyecto incluido.
El ejemplo más claro es la hora. En las 13 columnas de fecha de los dos conjuntos ingeridos —1.616.671 procesos y 509.363 contratos— el 100% de las marcas de tiempo viene con hora 00:00:00, sin una sola excepción. OCDS exige fecha y hora con zona horaria. Y SECOP II conoce el instante exacto del cierre, porque deja de recibir ofertas en ese instante: es el volcado tabular el que trunca. Pedir que no se pierda el dato es más barato que pedir que se capture.
Con los beneficiarios finales pasa algo parecido. El registro ya existe —Ley 2155 de 2021, administrado por la DIAN— pero su consulta está reservada a ciertas entidades y no se cruza con SECOP. No hay que crearlo. Hay que conectarlo.
Un solo punto no tiene equivalente en ningún estándar, y es el más importante: que el ordenador del gasto tenga que consignar, bajo su nombre, por qué un proceso competitivo cerró con un único oferente. OCDS permite contar los oferentes y justificar la modalidad elegida, pero en ninguna parte contempla una explicación atribuible de por qué la competencia no se produjo. Como un único oferente es el resultado más frecuente del sector, la anomalía más común del sistema de compras no tiene hoy ninguna explicación registrada. Un campo obligatorio y con nombre propio convierte una inferencia estadística en una afirmación que alguien firmó — y la ausencia de esa firma pasa a ser, ella misma, el hallazgo.
Los campos se contrastaron contra el esquema OCDS 1.1 y el registro de extensiones. No fue posible inspeccionar la publicación colombiana en vivo, porque su API respondió 502 en todos los extremos consultados: lo afirmado sobre el estándar está verificado, y lo afirmado sobre el contenido del flujo colombiano se declara como inferencia. La ausencia de cada campo en los conjuntos tabulares sí se verificó directamente.
Validación
Inyección sintética. Se clonan contratos reales, se les inyecta un patrón por detector —once en total— y se mide si sobreviven al pipeline completo. Un caso que un detector marca pero las compuertas suprimen cuenta como no detectado, porque eso es lo que pasaría en producción. Recall actual: 100%, antes y después de las compuertas.
La medición misma hubo que corregirla. Cubría seis detectores, y al extenderla a los cuatro restantes apareció que el contador aceptaba como recuperado un caso que hubiera marcado cualquier detector. Los contratos clonados heredan las cifras de ejecución de su plantilla, así que otro detector disparaba sobre ellos por su cuenta y D10 figuraba como cubierto sin haber disparado nunca. Ahora se exige el detector esperado. Una medición capaz de reportar éxito sobre un patrón que no midió es peor que no medir.
Ranking contra sanciones registradas. Usando como etiquetas débiles los proveedores con sanciones en SECOP, y excluyendo el detector que las usa como insumo para evitar circularidad: la tasa base de proveedores sancionados es del 0,148% y la precisión@25 es del 4%, un lift de 27x.
Ese segundo resultado no debe sobrevenderse. Con 138 proveedores etiquetados sobre 13.761 casos rankeados, una precisión@25 del 4% equivale literalmente a un proveedor, y la precisión@10 es cero. A esa profundidad es indistinguible del azar. El ejercicio sirve para descartar el escenario vergonzoso —un ranking peor que aleatorio— no para afirmar exactitud. Y un proveedor sin sanción registrada tampoco es necesariamente limpio: puede que nunca lo hayan detectado.
Naturaleza y límites
Este sistema no detecta corrupción. Detecta anomalías estadísticas y patrones de riesgo en datos públicos, y todos requieren verificación humana. Un hallazgo no es una acusación, ni una prueba, ni una imputación. El destinatario natural de estos reportes son la Contraloría, la Procuraduría y las veedurías ciudadanas.
En la exportación pública la seudonimización ocurre al exportar, no al renderizar: el archivo que llega al navegador nunca contiene un documento real. La política tiene tres categorías.
- Entidades estatales: se publican íntegras, a ambos lados del contrato. Nombrar a un organismo público es justamente para lo que existe el control, y la ley de transparencia hace pública esa información para que pueda escrutarse.
- Personas naturales: seudónimo salado. Representantes legales, supervisores, ordenadores del gasto, coincidencias PEP y cualquier contratista con cédula en vez de NIT.
- Empresas privadas, consorcios y uniones temporales: seudónimo salado. El análisis se lee igual sin ellas: lo relevante es que un proveedor concentre una participación, no cuál. Si un NIT cuenta como estatal se decide por un hecho en los datos —si aparece alguna vez como entidad contratante— y no por conjeturas sobre el nombre.
Limitación declarada. El enlace al proceso sí se publica, y esa página de SECOP sí nombra al contratista. Seudonimizar una empresa evita que este sitio afirme la asociación en texto indexable; no vuelve el nombre inaccesible. Es una protección real, pero acotada, y se dice así en lugar de insinuar la versión fuerte.
La garantía se verifica sobre el archivo que realmente se publica. El comando
elephant verify-export saca del almacén los 140.724 documentos de personas naturales, los
232.890 nombres personales y las 11.664 razones sociales privadas, los busca dentro del JSON
y falla si encuentra alguno. De los 150 hallazgos publicados, 113 proveedores quedan bajo
seudónimo de empresa, 25 bajo seudónimo de persona y 12 se nombran por ser entidades
estatales.
Riesgo residual declarado: el objeto contractual se republica tal como lo publica SECOP, sin seudonimizar, así que puede contener nombres de forma incidental. La verificación lo reporta aparte en lugar de esconderlo.
Estado honesto
El pipeline corre de extremo a extremo sobre todo el sector salud. Lo que falta:
- La auditoría manual de falsos positivos no se ha hecho. Los 48 hallazgos no han sido revisados uno por uno. Sin eso, la precisión real del sistema es desconocida.
- El backtest contra sanciones es demasiado escaso para concluir nada, por las razones de arriba.
- El recall se mide sobre patrones sintéticos, no sobre fraude real. Los once detectores tienen su caso, pero un patrón inyectado es un patrón que alguien diseñó sabiendo qué busca el detector. El número acota el daño de las compuertas, no la capacidad de encontrar fraudes que nadie anticipó.
- D11 no ha sido validado por un humano. Sus 220 señales son desacuerdos entre el texto y el código declarado. Cuáles son errores de codificación y cuáles errores del modelo sólo lo resuelve la revisión: el piso de ruido medido acota lo segundo, no lo primero.
- D10 sigue siendo el detector más ruidoso con 7.959 señales crudas, ya sin las 1.824 que venían de contratos sin clasificar. La compuerta de tasa base lo contiene, pero la publicación del PAA es irregular y el detector merece un umbral más fino.
- Las recomendaciones se contrastaron contra OCDS, no contra la ANCP. El ejercicio cambió el diagnóstico, pero no se ha discutido con Colombia Compra Eficiente, y la publicación colombiana no pudo inspeccionarse en vivo. Puede que algún campo que aquí se da por ausente sí esté disponible por esa vía.
- El análisis documental de pliegos y estudios previos queda para una segunda fase. Es la parte que leería los documentos y no sólo los datos estructurados.
Highlights
- 509.358 contratos de salud por COP 59,8 billones, tamizados hasta 48 hallazgos: uno por cada 10.612 contratos
- 26.686 señales crudas → 48 hallazgos y 14.086 observaciones, tras cinco compuertas anti-falsos-positivos
- 11 detectores. Diez son reglas deterministas; el undécimo usa un clasificador que mide, pero ningún modelo decide qué se reporta
- Recall del 100% sobre once patrones inyectados, medido después de las compuertas y no antes
- Ningún hallazgo llega al nivel máximo con hipótesis benignas abiertas: la invariante la impone el modelo de datos, no la disciplina
Challenges
Outcomes
- Pipeline ejecutable de extremo a extremo: ingest → build → train → scan → report → backtest → inject → export
- 14.134 dossiers en español, cada uno con la estadística de sus comparables, las hipótesis descartadas, las que siguen abiertas y los próximos pasos
- 176 pruebas, incluidas las invariantes de nivel, las garantías de seudonimización y el límite de lo que el modelo puede decidir
- Cobertura del join contrato→proceso del 96,7% sobre la clave CO1.BDOS
Demo
Cargando resultados del análisis…